
Разберём, как составить семантическое ядро, из которого вырастут структура сайта и план контента под Яндекс в вашем регионе.
Каждый шаг покажем на примере нашего сайта (сентябрь 2026 года, Яндекс, Москва).
Содержание
- Что это и зачем
- Виды запросов
- 6 шагов сбора
- Что делать дальше
- Наш пример
- Сервисы
- Магазин, новый и работающий сайт
- Ошибки
- Чек-лист
Что такое семантическое ядро сайта и зачем оно нужно
Семантическое ядро (СЯ), или семантика сайта, — упорядоченный список поисковых запросов и ключевых слов, по которым сайт должен находиться в поиске.
В рабочем виде это запросы с частотностью, разбитые на группы. Одна группа — один URL. В таблице это столбцы: запрос, частотность, кластер, тип страницы или URL.
Например, строки из нашего ядра (Москва, Arsenkin, 29.09.2026):
| Запрос | Базовая частотность | Точная частотность |
|---|---|---|
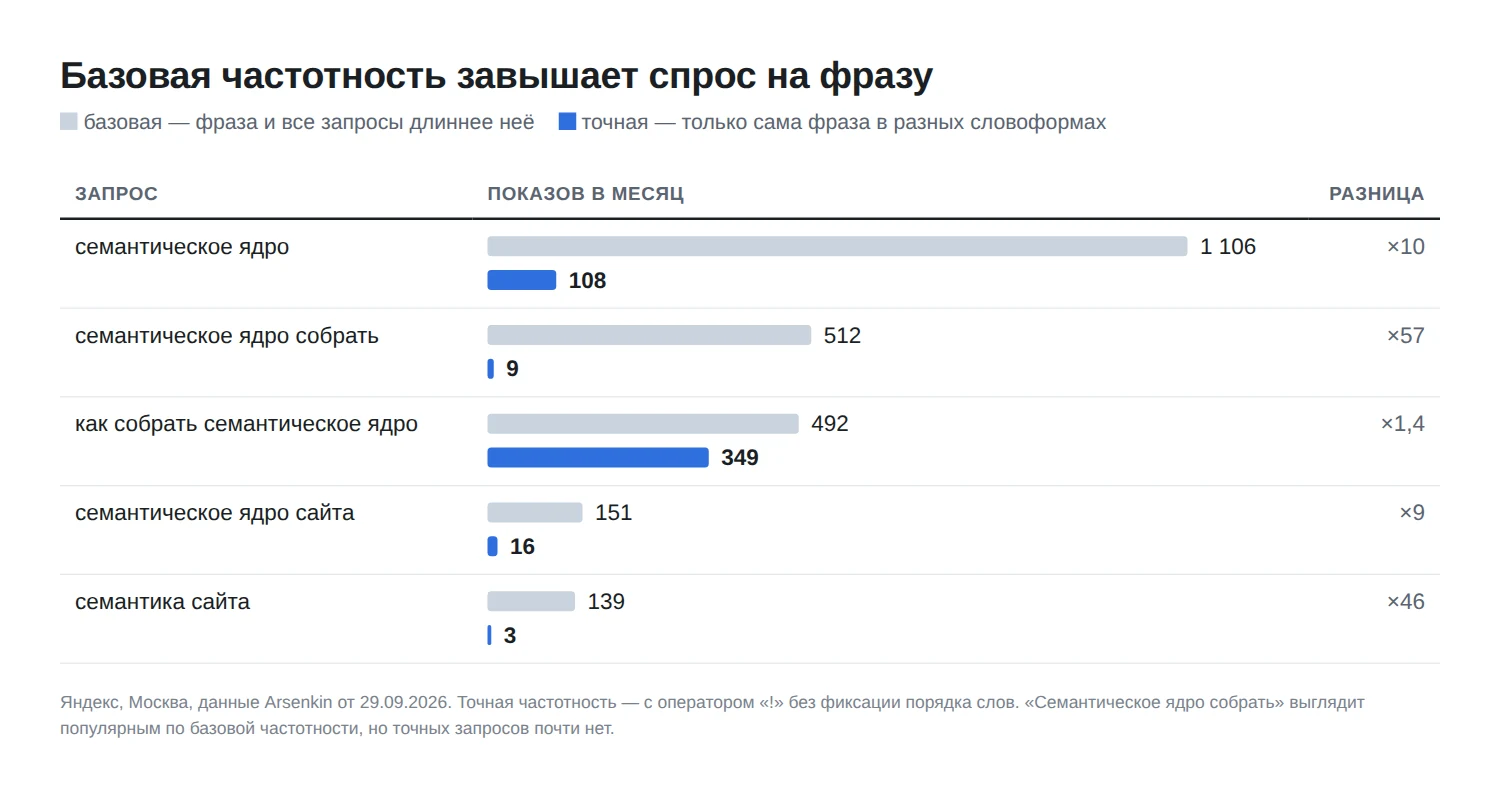
| как собрать семантическое ядро | 492 | 349 |
| семантическое ядро | 1 106 | 108 |
Кластер и страница появятся на шагах 5 и 6.
По ядру строят структуру сайта, тексты и заголовки, контент-план блога и список запросов для отслеживания позиций в Яндексе и Google. Для SEO-продвижения правильная семантика — путь к целевому трафику и потенциальным клиентам.
Ядро без кластеризации — ещё не рабочий инструмент. Список ключевых слов не говорит, какую страницу создавать или оптимизировать.
Какие бывают поисковые запросы
По интенту
Рабочая классификация: информационные («как собрать семантическое ядро»), коммерческие, транзакционные, навигационные и брендовые. Коммерческий запрос выдают маркеры «купить», «цена», «заказать», «доставка», «сколько стоит».
Но маркер только подсказывает. У нас словарная разметка не определила интент у 1 028 ключей из 1 431, а 264 информационных и 139 коммерческих остались гипотезой. Окончательный интент снимают по выдаче, на шаге кластеризации.
Интент кластера задаёт формат: информационные кластеры уходят в статьи, коммерческие — в услуги и категории, часть с привязкой к региону. Например, у нас «продвижение сайта» легло на услугу с гео-привязкой, а «robots txt» — в статью.
По частотности и региону
Частотность показывает, сколько раз в месяц запрос ищут в Яндексе: на вкладке «Топы запросов» Вордстат даёт данные за последний месяц. Высокочастотные, среднечастотные и низкочастотные запросы сравнивают внутри своей семантики, границы зависят от ниши.
Кроме спроса оценивают уровень конкуренции по запросу. Его показывает, например, бета-инструмент подбора запросов по рынку в Вебмастере.
Частота и выдача зависят ещё и от региона, у нас это Москва.
Как собрать семантическое ядро по шагам
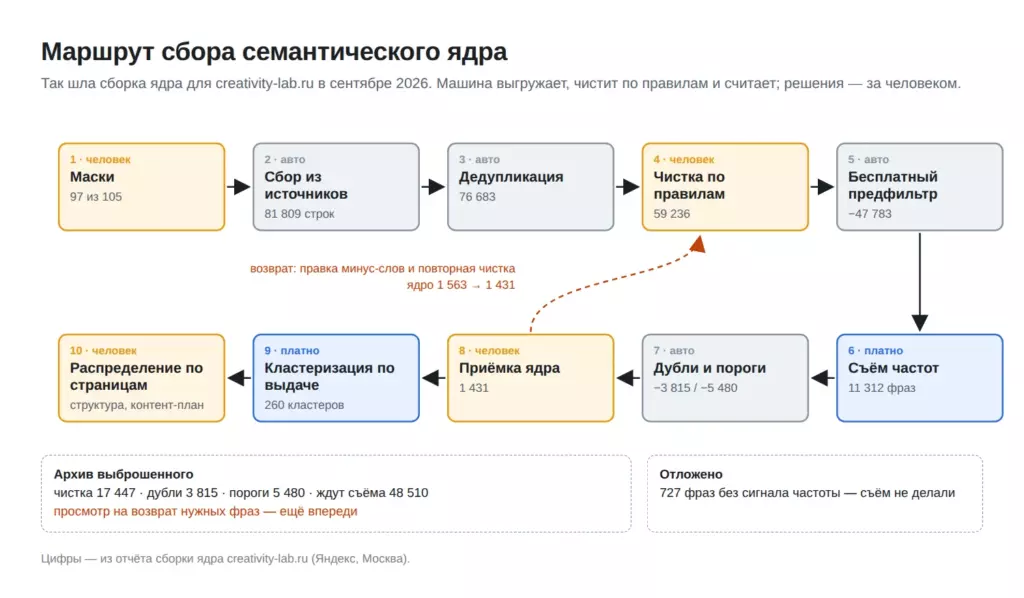
Маршрут такой: маркерные запросы → расширение списка → чистка → проверка частотности → кластеризация по выдаче → распределение по страницам.
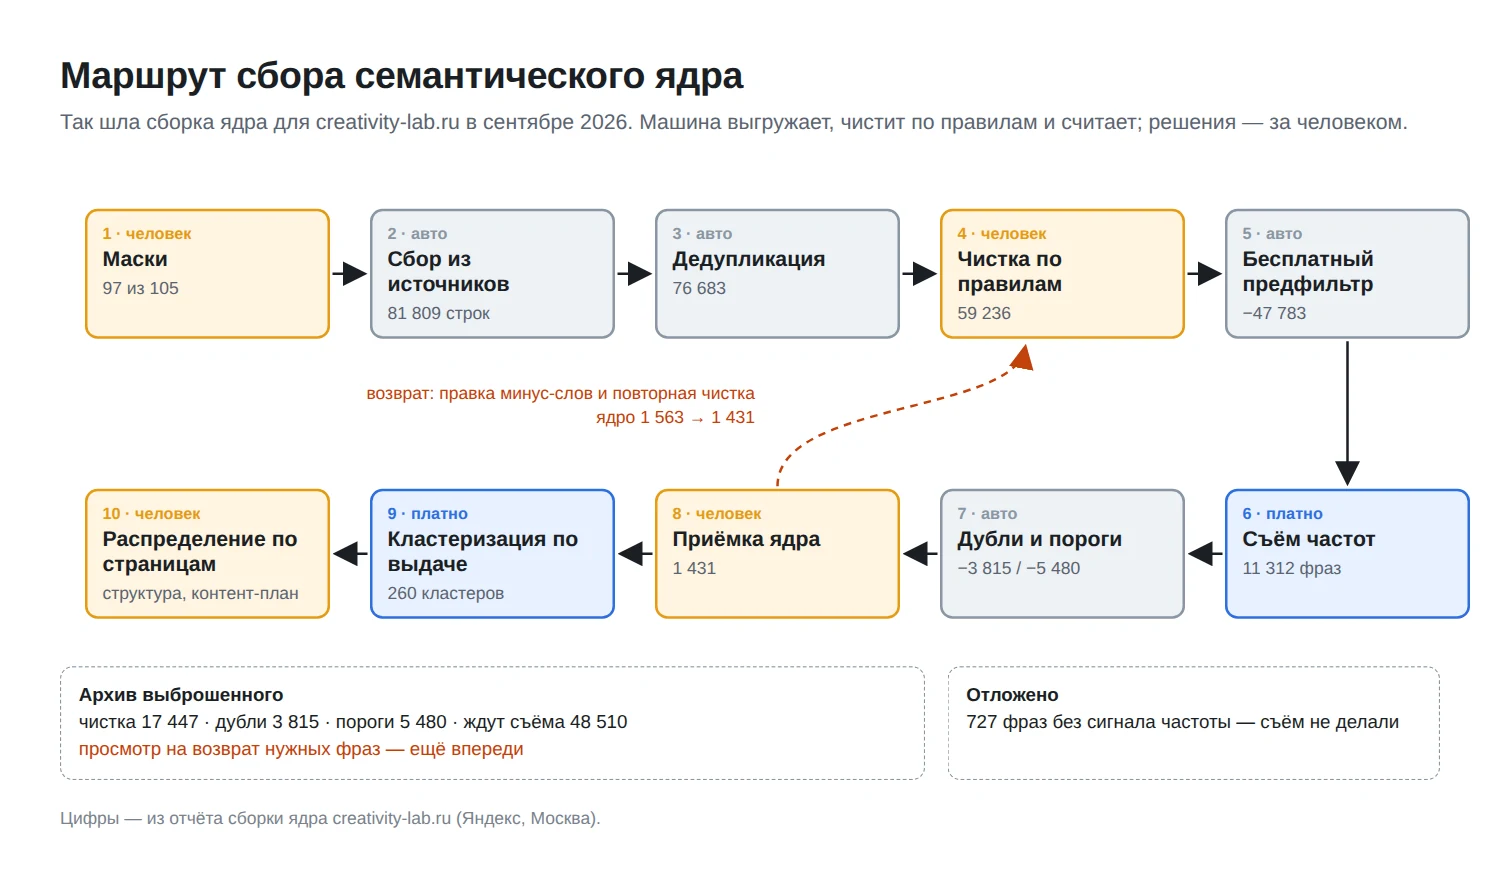
На деле маршрут не прямой.
У нас приёмка ядра вернула работу к правке минус-словаря и повторной чистке. Пул сократился с 60 215 до 59 236 фраз, ядро — с 1 563 до 1 431. Выброшенное лежит в архиве и ждёт просмотра, а съём 727 фраз без сигнала частоты отложен.
Чистка стоит до платной проверки частотности: каждый лишний ключ на съёме стоит денег или лимитов. У нас бесплатный предфильтр по уже выгруженной базе Букварикса отсеял 47 783 фразы с нулевой точной частотностью по всему миру, 80,7% пула.
Выгрузку, дедупликацию, съём частот и кластеризацию делает машина. 69 099 строк Букварикса выгрузились за 1,9 с, съём частот по 11 312 фразам занял около 11,5 минуты.
Решения у нас остаются за человеком. Он утверждает маски и правила минус-слов, принимает ядро и просматривает выброшенное.
Шаг 1. Составьте список маркерных запросов
Маркерные (базовые) запросы — короткие фразы о товарах и услугах бизнеса. Источники — разделы сайта, потребности и формулировки целевой аудитории, мозговой штурм, синонимы, анализ конкурентов.
Маски определяют охват: сбор физически не может найти то, о чём не спросили.
Это вывод из нашего отчёта. Маски тоже проверяют: из 105 предложенных мы приняли 97, восемь отбраковали.
Шаг 2. Расширьте список ключевых слов через Wordstat, подсказки и конкурентов
Расширяют семантику через Яндекс Вордстат, поисковые подсказки, базы ключевых слов, поисковые запросы конкурентов из сервисов анализа и свои запросы из Вебмастера и Google Search Console.
В Вордстате популярные и похожие запросы видны на вкладке «Топы запросов». Регион и тип устройства задаются фильтром.
Наши восемь выгрузок четырёх типов дали 81 809 строк, без точных дублей — 76 683 фразы. Вклад источников неравный:
| Источник | Строк | Фраз в ядре |
|---|---|---|
| База Букварикса | 69 099 | 1 225 |
| Выгрузки по пяти конкурентам | 11 155 | 408 |
| Search Console | 1 055 | 47 |
| Вебмастер | 500 | 4 |
Сумма в последнем столбце больше 1 431: у одного ключа бывает несколько источников.
Шаг 3. Почистите ядро от мусора и дублей
Убирайте дубли, нецелевые запросы (скачать, бесплатно, работа, чужая вертикаль), бренды конкурентов, обрывки, слишком длинные фразы и запросы с URL. Минус-слова и стоп-слова собирайте в словарь.
У нас 19 правил убрали 17 447 фраз, из 76 683 осталось 59 236. Больше всех — инфо-мусор: 4 079 ключевых слов вроде «seo перевод».
Была и ловушка омонимии. «Seo» оказалось ещё и корейским именем, и отдельное правило убрало 957 фраз вроде «seo taiji».
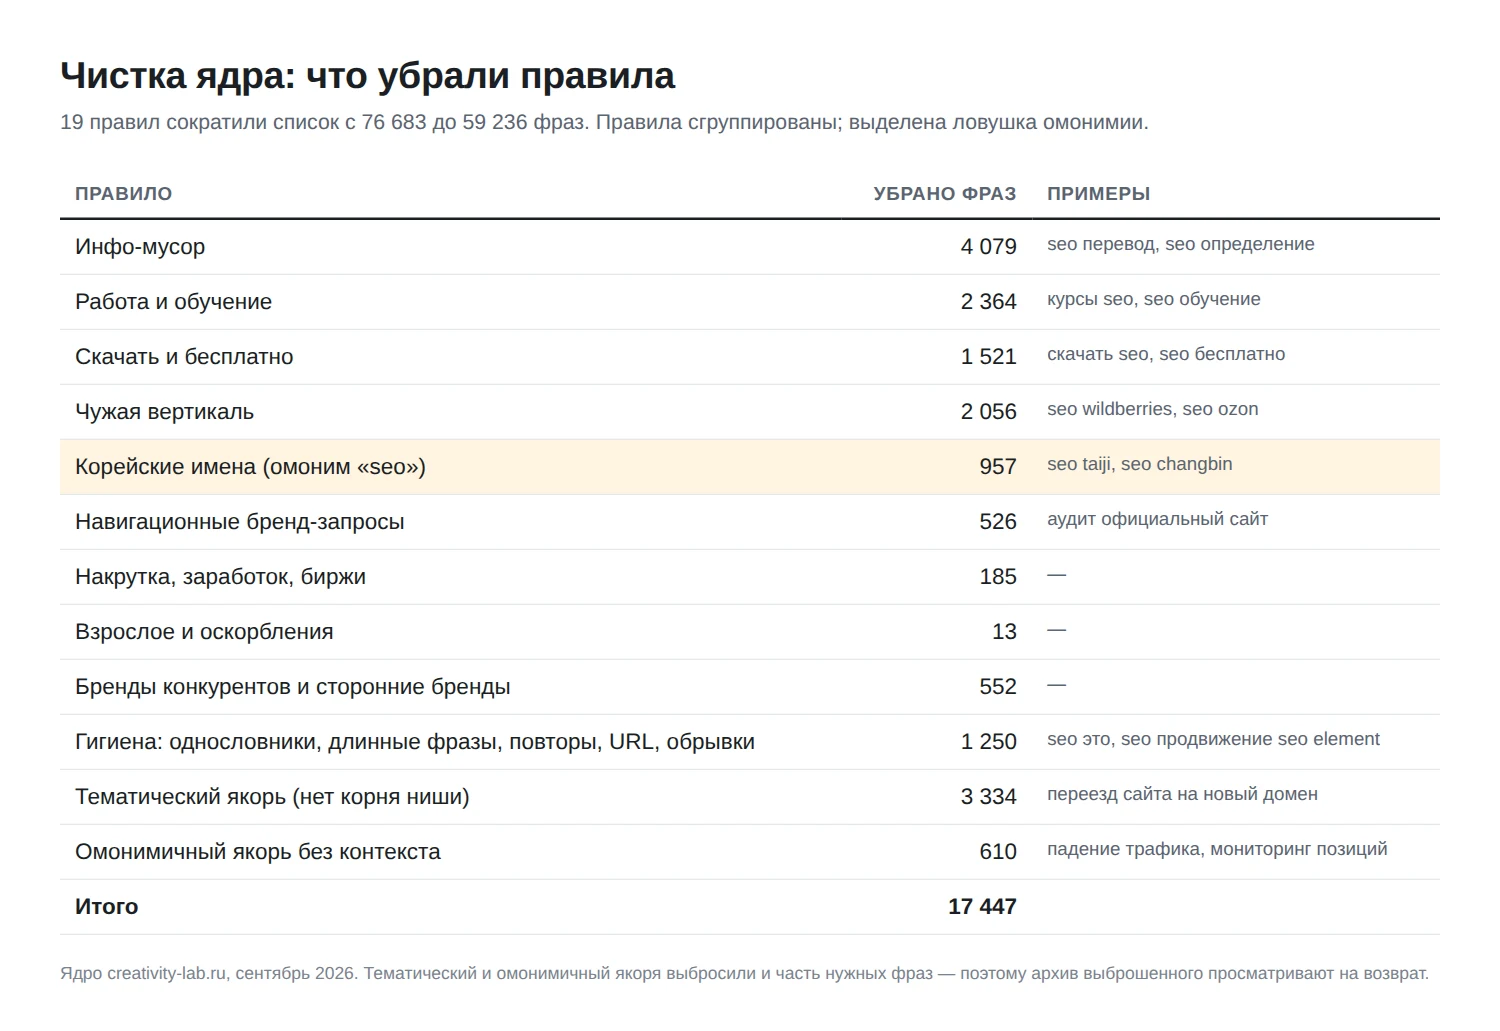
Чистка может выбросить и нужное.
Правило тематического якоря убрало «переезд сайта на новый домен», омонимичного — «мониторинг позиций». Поэтому архив выброшенного просматривают и возвращают нужные ключи. У нас этот просмотр ещё впереди.
Неявные дубли (словоформы одной фразы) здесь только помечают. У нас таких кандидатов было 29 534, а схлопывали их уже после съёма частот.
Шаг 4. Проверьте точную частотность в нужном регионе
Базовая частотность Вордстата учитывает и более длинные поисковые запросы с теми же словами, поэтому спрос на саму фразу она завышает.
Точную частоту дают операторы. По справке Вордстата «!» фиксирует форму слова, кавычки — количество слов, квадратные скобки — порядок. Чтобы отсечь и более длинные запросы, и другие словоформы, операторы комбинируют: "!как !собрать !семантическое !ядро".
Мы снимали точную частоту без фиксации порядка слов, то есть без квадратных скобок. У «семантического ядра» из таблицы выше разница больше чем в десять раз.
Почему регион меняет цифры
Ручная выгрузка без указанного региона разошлась с московскими данными: по 881 фразе её базовая частотность по медиане в 5,8 раза выше. «Продвижение сайта» — 37 457 против 7 502. Вероятно, выгрузка была не по Москве (не проверено), поэтому в ядро мы взяли только московские частоты.
Регион фиксируйте до съёма.
Какие фразы отсеять после съёма
Ключевые слова с нулевой точной частотностью в ядро не идут, у нас таких было 5 480. После схлопывания 3 815 словоформ и отсева по порогам осталась 1 431 фраза.
Высокое отношение базовой частоты к точной — повод проверить фразу, низкое ничего не доказывает. Медиана отношения в нашем ядре — 3,0.
Шаг 5. Проведите кластеризацию запросов по выдаче
Кластеризация — группировка поисковых запросов, которые можно продвигать одной страницей. Надёжнее группировать по совпадению адресов в топе выдачи, чем по общим словам.
Принцип: один кластер, один интент, одна страница. Иначе страницы конкурируют за одни запросы (каннибализация).
У нас 1 431 фраза дала 260 кластеров (1 054 фразы) и 377 одиночек. URL кластеров брали из выдачи через Arsenkin. Кластер «семантическое ядро», например, — 20 ключевых слов с информационным интентом.
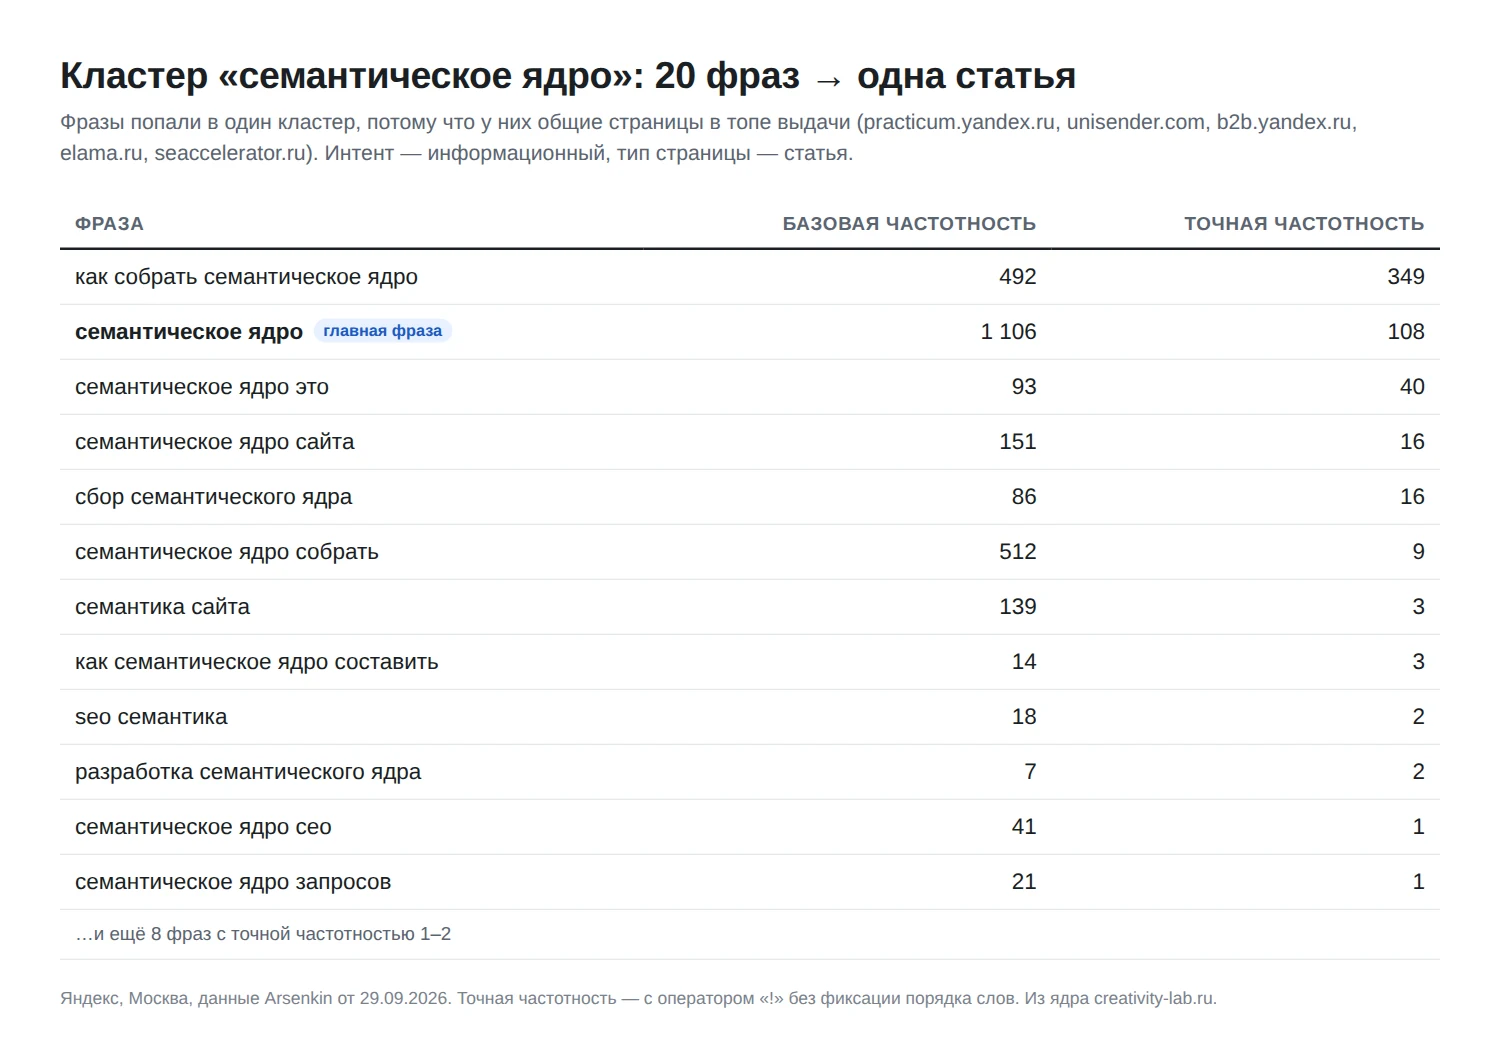
Одиночки — не мусор.
У них просто не нашлось общей выдачи: часть станет отдельными страницами, часть уйдёт в тексты. Длинный хвост из пяти и более слов кластеризовали отдельно, с более мягким порогом: общих URL у них меньше.
Шаг 6. Распределите кластеры по страницам
Цепочка: кластер → тип страницы (главная, услуга с гео-привязкой, категория, карточка товара, статья блога) → существующий или новый URL. За каждым URL закрепляйте один кластер.
Формат у нас назначало правило по интенту, гео и вопросности. Правило — подсказка, под нишу его меняют. Одиночки распределяют вручную: в тексты подходящих разделов или в план новых.
Что делать с готовым семантическим ядром
Не оставляйте его файлом в папке.
Сначала структура сайта, затем контент-план: какие статьи и коммерческие страницы создать и в каком порядке. Дальше ТЗ на тексты и заголовки, перелинковка разделов одной темы и оптимизация существующих.
Важные запросы добавьте в «Избранные» в Вебмастере и следите за средней позицией. В отчёте об эффективности Search Console видно, по каким запросам страница начала показываться.
Семантику обновляют при запуске новых услуг или разделов и при изменении спроса.
Пригодится оно и для Яндекс Директа: ключевые слова и минус-фразы.
Как мы собрали семантическое ядро для своего сайта
Воронка ядра creativity-lab.ru целиком (сентябрь 2026, Яндекс, Москва):
| Этап | Фраз |
|---|---|
| Собрано из источников | 81 809 |
| Без точных дублей | 76 683 |
| После чистки | 59 236 |
| Отправлено на съём частотности | 11 312 |
| Со снятой частотой в итоговом пуле | 10 726 |
| В ядре | 1 431 |
| Кластеров / одиночных фраз | 260 / 377 |
Про строку 11 312: 586 ключей с уже снятой частотой ушли на приёмке после правки минус-словаря. Лимиты за них потрачены, это цена возврата к чистке.
До ядра дошло меньше 2% собранных строк.
Платная часть — 22 672 лимита Arsenkin: 48 на тесты, остальное на два типа частотности для 11 312 фраз.
Сервисы для сбора семантики и ключевых слов
Инструменты по задачам, доступ указан по страницам сервисов на 1 октября 2026 года:
| Задача | Примеры | Доступ |
|---|---|---|
| Частотность и расширение | Яндекс Вордстат, Wordstat Assistant | аккаунт Яндекса; Assistant — расширение браузера |
| Базы фраз | Букварикс | бесплатно |
| Запросы конкурентов | Keys.so, SpyWords, Semrush, Serpstat | платные, есть пробный или бесплатный режим |
| Свои запросы | Вебмастер, Search Console, Метрика | данные своего сайта |
| Обработка | Key Collector, Excel | программа и таблицы |
| Съём частот и кластеризация | Arsenkin | платный, по лимитам |
Отчёты Вебмастера и Search Console по запросам доступны по подтверждённому сайту: владельцу и тем, кому он выдал доступ.
Ядро для интернет-магазина, нового и работающего сайта
Новый сайт. Составить семантическое ядро нужно до разработки, чтобы структура и разделы сразу строились под спрос. Своих данных поиска нет, опора — маски, базы ключевых слов, конкуренты и подбор запросов по рынку в Вебмастере (бета).
Работающий сайт. Добавьте его запросы: у нас 725 из 1 055 строк Search Console и 489 из 500 строк Вебмастера не встречались в других источниках.
Интернет-магазин. Больше коммерческих запросов и форматов: категории, фильтры, карточки товаров. Информационные кластеры уходят в блог.
Сколько запросов должно быть в ядре? Зависит от ниши и ассортимента. У нас 1 431 фраза, для другого сайта эта цифра ничего не задаёт.
Типичные ошибки при составлении семантического ядра
Только высокочастотные запросы. Теряется низкочастотный хвост с темами для новых материалов.
Частотность без региона. Структура строится на чужом спросе.
Нулевая точная частота. Страницы создаются под спрос, которого нет.
Словарный интент как окончательный. Коммерческие и информационные запросы смешиваются в одной группе, и страница не отвечает ни одному интенту.
Группировка по общим словам и выброшенные одиночки. Страницы конкурируют между собой, темы для текстов теряются.
Забытый архив. Нужные ключи остаются среди выброшенного, а семантика без обновлений отстаёт от бизнеса.
Чек-лист сбора семантического ядра
Проверьте своё ядро или работу подрядчика:
- маски согласованы;
- источники собраны;
- дубли и мусор убраны;
- архив выброшенного просмотрен;
- точная частотность снята в нужном регионе;
- кластеры собраны по выдаче;
- каждый кластер закреплён за страницей.
Если на сбор семантики нет времени или нужен второй взгляд на готовое ядро, обсудите проект с нашей командой или получите консультацию.